递归函数的致命缺陷:巨大的时间开销和内存开销(附带优化方案)
递归函数的空间开销
在程序占用的整个内存中,有一块内存区域叫做栈(Stack),它是专门用来给函数分配内存的,每次调用函数,都会将相关数据压入栈中,包括局部变量、局部数组、形参、寄存器、冗余数据等。栈是针对线程来说的,每个线程都拥有一个栈,如果一个程序包含了多个线程,那么它就拥有多个栈。目前我们编写的程序都是单线程的,所以不必考虑多线程的情况。
对每个线程来说,栈能使用的内存是有限的,一般是 1M~8M,这在编译时就已经决定了,程序运行期间不能再改变。如果程序使用的栈内存超出最大值,就会发生栈溢出(Stack Overflow)错误。
栈内存的大小和编译器有关,编译器会为栈内存指定一个最大值,在 VC/VS 下,默认是 1M,在 C-Free 下,默认是 2M,在 Linux GCC 下,默认是 8M。当然,我们也可以通过参数来修改栈内存的大小。
发生函数调用时会将相关数据压入栈中,函数调用结束会释放这一部分内存,对于一般的函数来说,这不会有任何问题,但是对于递归函数,这会导致严重的问题!
递归函数内部嵌套了对自身的调用,除非等到最内层的函数调用结束,否则外层的所有函数都不会调用结束。通俗地讲,外层函数被卡住了,它要等待所有的内层函数调用完成后,它自己才能调用完成。
每一层的递归调用都会在栈上分配一块内存,有多少层递归调用就分配多少块相似的内存,所有内存加起来的总和是相当恐怖的,很容易超过栈内存的大小限制,这个时候就会导致程序崩溃。
例如,一个递归函数需要递归 10000 次,每次需要 1KB 的内存,那么最终就需要 10MB 的内存。
为了演示由于栈溢出而导致程序崩溃的情形,下面我们用递归的方式来求 1+2+3+ ...... + (n-1) + n 的值:
#include <stdio.h>

long sum(int n) {
    //为了增加每次函数调用的内存,额外增加了一个无用的数组,它占用 1KB 的内存
    int arr[250];

    if (n <= 1) {
        return n;
    } else {
        return  n + sum(n-1);
    }
}

int main() {
    printf("从1加到1000的值为 %ld\n", sum(1000));
    return 0;
}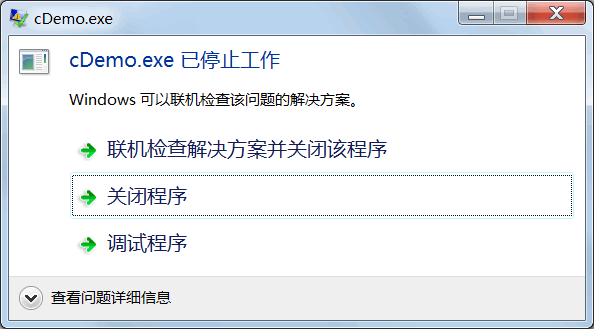
这是因为,每次递归调用都需要超过 1KB 的内存(仅仅数组就占用了 1KB 内存),而要得到最终的结果需要 1000 次递归调用,这样一来,所有内存的总和就超过了 1MB。
上面我们说过,Visual Studio 默认的栈内存只有 1MB,超过这个界限程序就无法运行了,只能让它崩溃。使用其它的编译器也许程序不会崩溃,读者可以亲自尝试。
递归函数的时间开销
每次调用函数都会在栈上分配内存,函数调用结束后再释放这一部分内存,内存的分配和释放都是需要时间的。每次调用函数还会多次修改寄存器的值,函数调用结束后还需要找到上层函数的位置再继续执行,这也是需要时间的。
所有的这些时间加在一起是非常恐怖的。
下面我们以「求斐波那契数」为例来演示双层递归的时间开销。
#include <stdio.h>
#include <time.h>

// 递归计算斐波那契数
long fib(int n) {
    if (n <= 2) {
        return 1;
    }
    else {
        return fib(n - 1) + fib(n - 2);
    }
}

int main() {
    int a;
    clock_t time_start, time_end;

    printf("Input a number: ");
    scanf("%d", &a);
    time_start = clock();
    printf("Fib(%d) = %ld\n", a, fib(a));
    time_end = clock();
    printf("run time: %lfs\n", (double)(time_end - time_start)/ CLOCKS_PER_SEC );

    return 0;
}Input a number: 42↲
Fib(42) = 267914296
run time: 13.137000s
可以看到,为了求 42 的斐波那契数程序竟然运行了 13 秒,简直让人发指。
使用迭代来替换递归函数
既然递归函数的解决方案存在巨大的内存开销和时间开销,那么我们如何进行优化呢?优化个毛,这是函数实现原理层面的缺陷,无法优化。其实,大部分能用递归解决的问题也能用迭代来解决。所谓迭代,就是循环。
许多问题是以递归的形式进行解释的,这只是因为它比非递归形式更为清晰。但是,这些问题的迭代实现往往比递归实现效率更高,虽然代码的可读性可能稍差一些。
与递归函数相比,迭代不但没有额外的内存开销,也没有额外的时间开销。
下面我们分别用递归和迭代的方案来求斐波那契数,看看它们究竟孰快孰慢。
#include <stdio.h>
#include <time.h>

//递归计算斐波那契数
long fib_recursion(int n) {
    if (n <= 2) {
        return 1;
    }
    else {
        return fib_recursion(n - 1) + fib_recursion(n - 2);
    }
}

//迭代计算斐波那契数
long fib_iteration(int n){
    long result;
    long previous_result;
    long next_older_result;
    result = previous_result = 1;
    while (n > 2) {
        n -= 1;
        next_older_result = previous_result;
        previous_result = result;
        result = previous_result + next_older_result;
    }
    return result;
}

int main() {
    int a;
    clock_t time_start_recursion, time_end_recursion;
    clock_t time_start_iteration, time_end_iteration;

    printf("Input a number: ");
    scanf("%d", &a);

    //递归的时间
    time_start_recursion = clock();
    printf("Fib_recursion(%d) = %ld\n", a, fib_recursion(a));
    time_end_recursion = clock();
    printf("run time with recursion: %lfs\n", (double)(time_end_recursion - time_start_recursion)/ CLOCKS_PER_SEC );

    //迭代的时间
    time_start_iteration = clock();
    printf("Fib_iteration(%d) = %ld\n", a, fib_iteration(a));
    time_end_iteration = clock();
    printf("run time with iteration: %lfs\n", (double)(time_end_iteration - time_start_iteration) / CLOCKS_PER_SEC);

    return 0;
}Input a number: 42↲
Fib_recursion(42) = 267914296
run time with recursion: 13.173000s
Fib_iteration(42) = 267914296
run time with iteration: 0.000000s
你看,递归用了 13 秒,迭代几乎瞬间完成(接近 0 秒),迭代比递归快成千上万倍,这个差异是巨大的。
 微信扫码关注
 抖音扫码关注