整数在内存中是如何存储的,为什么它堪称天才般的设计
对于有符号数,内存要区分符号位和数值位,对于人脑来说,很容易辨别,但是对于计算机来说,就要设计专门的电路,这无疑增加了硬件的复杂性,增加了计算的时间。要是能把符号位和数值位等同起来,让它们一起参与运算,不再加以区分,这样硬件电路就变得简单了。
另外,加法和减法也可以合并为一种运算,就是加法运算,因为减去一个数相当于加上这个数的相反数,例如,5 - 3 等价于 5 + (-3),10 - (-9) 等价于 10 + 9。
相反数是指数值相同,符号不同的两个数,例如,10 和 -10 就是一对相反数,-98 和 98 也是一对相反数。
如果能够实现上面的两个目标,那么只要设计一种简单的、不用区分符号位和数值位的加法电路,就能同时实现加法和减法运算,并且非常高效。实际上,这两个目标都已经实现了,真正的计算机硬件电路就是如此简单。然而,简化硬件电路是有代价的,这个代价就是有符号数在存储和读取时都要进行转化。那么,这个转换过程究竟是怎样的呢?接下来我们就详细地讲解一下。
首先,请读者先记住下面的几个概念。
1) 原码
将一个整数转换成二进制形式,就是其原码。例如short a = 6;,a 的原码就是0000 0000 0000 0110;更改 a 的值a = -18;,此时 a 的原码就是1000 0000 0001 0010。通俗的理解,原码就是一个整数本来的二进制形式。
2) 反码
谈到反码,正数和负数要区别对待,因为它们的反码不一样。对于正数,它的反码就是其原码(原码和反码相同);负数的反码是将原码中除符号位以外的所有位(数值位)取反,也就是 0 变成 1,1 变成 0。例如
short a = 6;,a 的原码和反码都是0000 0000 0000 0110;更改 a 的值a = -18;,此时 a 的反码是1111 1111 1110 1101。3) 补码
正数和负数的补码也不一样,也要区别对待。对于正数,它的补码就是其原码(原码、反码、补码都相同);负数的补码是其反码加 1。例如
short a = 6;,a 的原码、反码、补码都是0000 0000 0000 0110;更改 a 的值a = -18;,此时 a 的补码是1111 1111 1110 1110。可以认为,补码是在反码的基础上打了一个补丁,进行了一下修正,所以叫“补码”。
原码、反码、补码的概念只对负数有实际意义,对于正数,它们都一样。
最后我们总结一下 6 和 -18 从原码到补码的转换过程:
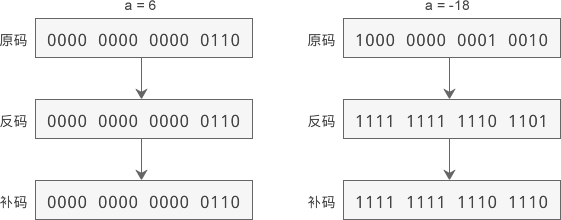
在计算机内存中,整数一律采用补码的形式来存储。这意味着,当读取整数时还要采用逆向的转换,也就是将补码转换为原码。正数的补码和原码相同,负数的补码转换为原码也很简单:先减去 1,再将数值位取反即可。
补码到底是如何简化硬件电路的
假设 6 和 18 都是 short 类型的,现在我们要计算 6 - 18 的结果,根据运算规则,它等价于 6 + (-18)。如果采用原码计算,那么运算过程为:
6 - 18 = 6 + (-18)
	= [0000 0000 0000 0110]原 + [1000 0000 0001 0010]原
	= [1000 0000 0001 1000]原
= -24于是人们开始继续探索,不断试错,后来设计出了反码。下面就演示了反码运算的过程:
6 - 18 = 6 + (-18)
	= [0000 0000 0000 0110]反 + [1111 1111 1110 1101]反
	= [1111 1111 1111 0011]反
	= [1000 0000 0000 1100]原
= -12然而,这样还不算万事大吉,我们不妨将减数和被减数交换一下位置,也就是计算 18 - 6 的结果:
18 - 6 = 18 + (-6)
	= [0000 0000 0001 0010]反 + [1111 1111 1111 1001]反
	= [1 0000 0000 0000 1011]反
	= [0000 0000 0000 1011]反
	= [0000 0000 0000 1011]原
	= 11
蓝色的 1 是加法运算过程中的进位,它溢出了,内存容纳不了了,所以直接截掉。
6 - 18 的结果正确,18 - 6 的结果就不正确,相差 1。按照反码来计算,是不是小数减去大数正确,大数减去小数就不对了,始终相差 1 呢?我们不妨再看两个例子,分别是 5 - 13 和 13 - 5。5 - 13 的运算过程为:
5 - 13 = 5 + (-13)
	= [0000 0000 0000 0101]原 + [1000 0000 0000 1101]原
	=  [0000 0000 0000 0101]反 + [1111 1111 1111 0010]反
	= [1111 1111 1111 0111]反
	= [1000 0000 0000 1000]原
	= -8
13 - 5 = 13 + (-5)
= [0000 0000 0000 1101]原 + [1000 0000 0000 0101]原
= [0000 0000 0000 1101]反 + [1111 1111 1111 1010]反
= [1 0000 0000 0000 0111]反
= [0000 0000 0000 0111]反
= [0000 0000 0000 0111]原
= 7相差的这个 1 要进行纠正,但是又不能影响小数减去大数,怎么办呢?于是人们又绞尽脑汁设计出了补码,给反码打了一个“补丁”,终于把相差的 1 给纠正过来了。
下面演示了按照补码计算的过程:
6 - 18 = 6 + (-18)
	= [0000 0000 0000 0110]补 + [1111 1111 1110 1110]补
	= [1111 1111 1111 0100]补
	=  [1111 1111 1111 0011]反
	= [1000 0000 0000 1100]原
	= -12

	18 - 6 = 18 + (-6)
	= [0000 0000 0001 0010]补 + [1111 1111 1111 1010]补
	= [1 0000 0000 0000 1100]补
	= [0000 0000 0000 1100]补
	= [0000 0000 0000 1100]反
	= [0000 0000 0000 1100]原
	= 12

	5 - 13 = 5 + (-13)
	=  [0000 0000 0000 0101]补 + [1111 1111 1111 0011]补
	= [1111 1111 1111 1000]补
	= [1111 1111 1111 0111]反
	= [1000 0000 0000 1000]原
	= -8

	13 - 5 = 13 + (-5)
	= [0000 0000 0000 1101]补 + [1111 1111 1111 1011]补
	= [1 0000 0000 0000 1000]补
	= [0000 0000 0000 1000]补
	= [0000 0000 0000 1000]反
	= [0000 0000 0000 1000]原
= 8小数减去大数,结果为负数,之前(负数从反码转换为补码要加 1)加上的 1,后来(负数从补码转换为反码要减 1)还要减去,正好抵消掉,所以不会受影响。
而大数减去小数,结果为正数,之前(负数从反码转换为补码要加 1)加上的 1,后来(正数的补码和反码相同,从补码转换为反码不用减 1)就没有再减去,不能抵消掉,这就相当于给计算结果多加了一个 1。
补码这种天才般的设计,一举达成了本文开头提到的两个目标,简化了硬件电路。
除了整数的存储,小数的存储也非常巧妙,也堪称天才般的设计,它的设计者还因此获得了图灵奖(计算机界的诺贝尔奖),我们将在《小数在内存中是如何存储的,揭秘诺贝尔奖级别的设计(长篇神文)》一节中介绍。
实例分析
上一节我们还留下了一个谜团,就是有符号数以无符号的形式输出,或者无符号数以有符号的形式输出时,会得到一个奇怪的值,请看下面的代码:#include <stdio.h>
int main()
{
short a = 0100; //八进制
int b = -0x1; //十六进制
long c = 720; //十进制
unsigned short m = 0xffff; //十六进制
unsigned int n = 0x80000000; //十六进制
unsigned long p = 100; //十进制
//以无符号的形式输出有符号数
printf("a=%#ho, b=%#x, c=%lu\n", a, b, c);
//以有符号数的形式输出无符号类型(只能以十进制形式输出)
printf("m=%hd, n=%d, p=%ld\n", m, n, p);
return 0;
}a=0100, b=0xffffffff, c=720
m=-1, n=-2147483648, p=100
其中,b、m、n 的输出结果看起来非常奇怪。
b 是有符号数,它在内存中的存储形式(也就是补码)为:
b = -0x1
	= [1000 0000 …… 0000 0001]原
	= [1111 1111 …… 1111 1110]反
	= [1111 1111 …… 1111 1111]补
= [0xffffffff]补%#x表示以无符号的形式输出,而无符号数的补码和原码相同,所以不用转换了,直接输出 0xffffffff 即可。m 和 n 是无符号数,它们在内存中的存储形式为:
m = 0xffff
	= [1111 1111 1111 1111]补

	n = 0x80000000
= [1000 0000 …… 0000 0000]补%hd和%d表示以有符号的形式输出,所以还要经过一个逆向的转换过程:
[1111 1111 1111 1111]补
	= [1111 1111 1111 1110]反
	= [1000 0000 0000 0001]原
	= -1

	[1000 0000 …… 0000 0000]补
	= -231
	= -2147483648
注意,
[1000 0000 …… 0000 0000]补是一个特殊的补码,无法按照本节讲到的方法转换为原码,所以计算机直接规定这个补码对应的值就是 -231,至于为什么,下节我们会详细分析。 微信扫码关注
 抖音扫码关注